高可用之路-观测篇-那些年遇到过的指标幻觉
当前AI的长程链路推到已经非常强大。一旦让Codex/CC接入可观测性平台,它能够非常好的利用工具进行各种组合获取相应的数据来得到问题根因(RCA)。但笔者遇到过的很多问题往往是在一些很反直觉的地方,无法通过现有的数据直接准确的推导到下一步,尤其体现在观测指标数据本身无法表达问题的情况下,这种很容易...
高可用之路-观测篇-那些年遇到过的指标幻觉
前言
当前AI的长程链路推到已经非常强大。一旦让Codex/CC接入可观测性平台,它能够非常好的利用工具进行各种组合获取相应的数据来得到问题根因(RCA)。但笔者遇到过的很多问题往往是在一些很反直觉的地方,无法通过现有的数据直接准确的推导到下一步,尤其体现在观测指标数据本身无法表达问题的情况下,这种很容易让AI跑偏,毕竟监控只是事实的投影。在这里,笔者就详细的阐述一下其中的一种表现—-指标幻觉,即指标指向的问题未必是真问题——-甚至可能没有问题。识破这些幻觉后,可以进一步提高我的AI分身的能力。
指标幻觉分类
当前笔者主要阐述的是观测指标幻觉,也即观测指标本身会误导我们找到RCA的种种情形。指标是我们为了反应整个业务情况而定义出的各种计数。这个计数可以是采集的数据Count/Guage或者对采集数据的运算(QPS/TPS等)。我们往往会定期的将指标读出并在时间轴上展示出来,并观察这个指标曲线来观测业务的变化。无论是计数本身还是读取计数的时间点都可能产生幻觉。
计数产生的幻觉
指标幻觉未必来自数据错误。很多时候,指标忠实地记录了它被设计来记录的东西,只是与我们以为它表达的事实其实有不少偏差。很多指标计数在定义的那一刻,就已经在某些情况下会产生无法表达的情况了,这个情况无法靠更换观测方式或者手段来解决。因为这是计数本身的固有限制。
数据表达空间饱和导致幻觉
这种情况往往是整个数据空间本身是有限的,而我们的指标只能在这个空间内腾挪。例如TCP端口号,最多从1-65535,也就是在五元组中的四元组固定(源IP:源端口:协议:目的IP:这四者固定)的情况下,能够同时存在的端口号也就65535个。在LVS中,一个五元组用一个表项表示。它衡量新建连接用的就是五元组表项的新增数量。对应源代码如下所示:
tcp_conn_schedule
		|->ip_vs_schedule
			/* 如果新建conn表项成功,则对已有连接数++ */
			|->ip_vs_conn_stats
而在我们的入口函数ip\_vs\_in中
static unsigned int
ip_vs_in(unsigned int hooknum, struct sk_buff *skb,
	 const struct net_device *in, const struct net_device *out,
	 int (*okfn) (struct sk_buff *))
{
	......
	// 如果能找到对应的五元组
	cp = pp->conn_in_get(af, skb, pp, &iph, iph.len, 0, &res_dir);

	if (likely(cp)) {
		/* For full-nat/local-client packets, it could be a response */
		if (res_dir == IP_VS_CIDX_F_IN2OUT) {
			return handle_response(af, skb, pp, cp, iph.len);
		}
	} else {
		/* create a new connection */
		int v;
		// 找不到对应的五元组,则新建连接,同时conn++
		if (!pp->conn_schedule(af, skb, pp, &v, &cp))
			return v;
	}
	......
}
由于2MSL的存在,LVS在默认120s之后(FIN_WAIT/TIME_WAIT)才会回收表项。为了创建连接的性能考虑,TCP协议允许端口复用,LVS本身也会进行表项复用。但从上面代码可以看到,LVS的新建连接数conn++只是反映了表项的增长。所以这个监控指标完全无法反应端口复用的情况,就导致LVS的新建连接数在新建连接超过一定速率导致复用表项的时候产生失真。表项的增减表达空间是有限的,真实的新建连接数超过了这个限制。 这就会产生一个幻觉,明明新建连接速率变快了,但这个监控指标却会反应出来速率大幅下跌甚至跌0!如下图所示:
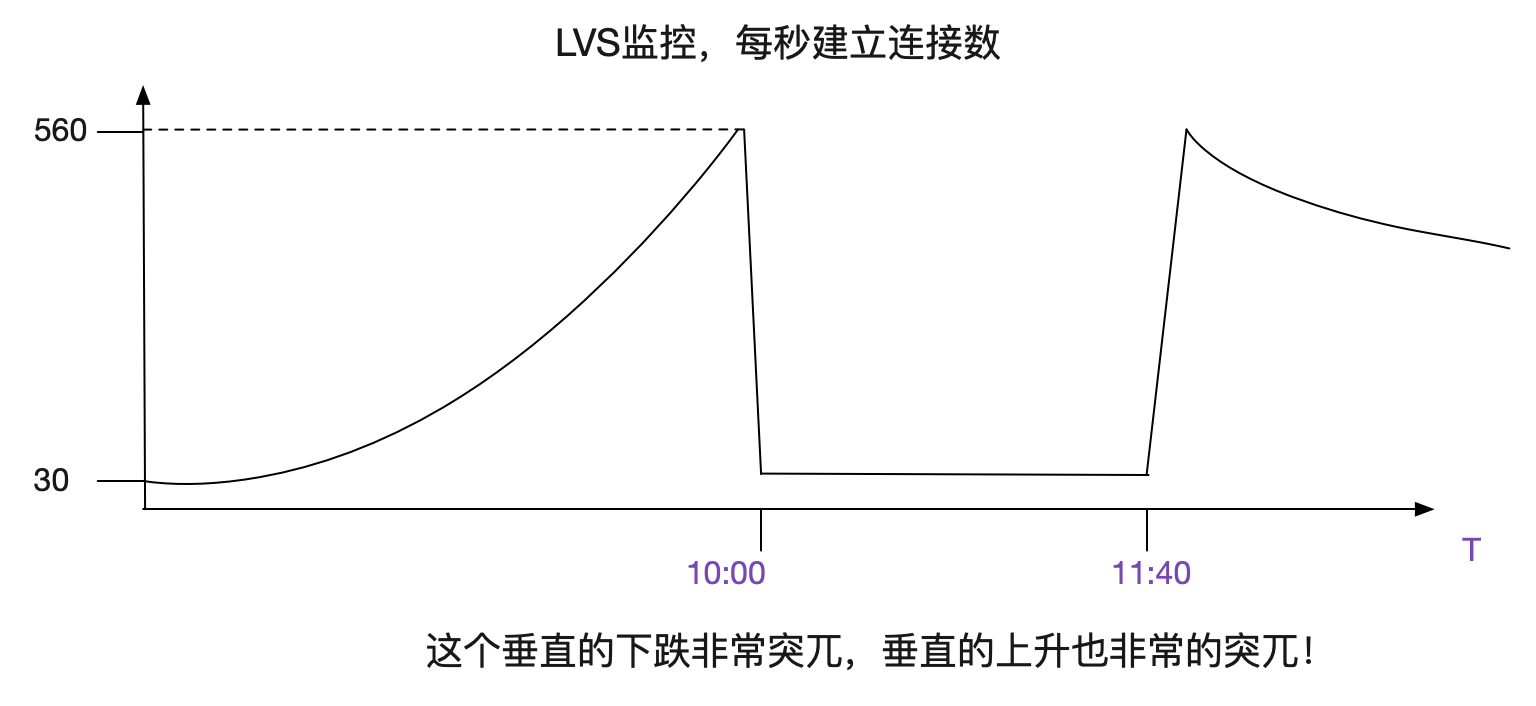
具体可以看笔者的这篇文章: https://www.alchemystar.net/articles/bug-nat-e95e7827.html
数据精度不够导致幻觉
当我们追求的指标精度超过了数据指标所能表达的精度范围之外也会产生幻觉。例如seconds_behind_master这个主从延迟的黄金指标。这个指标的单位是秒,也就是说它只能表达秒级的延迟,但有意思的是我们在监控计算上对它取平均的时候,往往会产生百毫秒这种错觉。也即一个从库是20ms延迟,另一个从库是500ms延迟。据此判定20ms从库比500ms从库主从延迟好就是从这个秒级指标衍生出来的幻觉,事实上这两可能在实际延迟中完全一样,唯一的不一样只在于主从连接的时候有没有由于主从clock的diff而在秒的维度产生较大的误差而已。如下图所示:
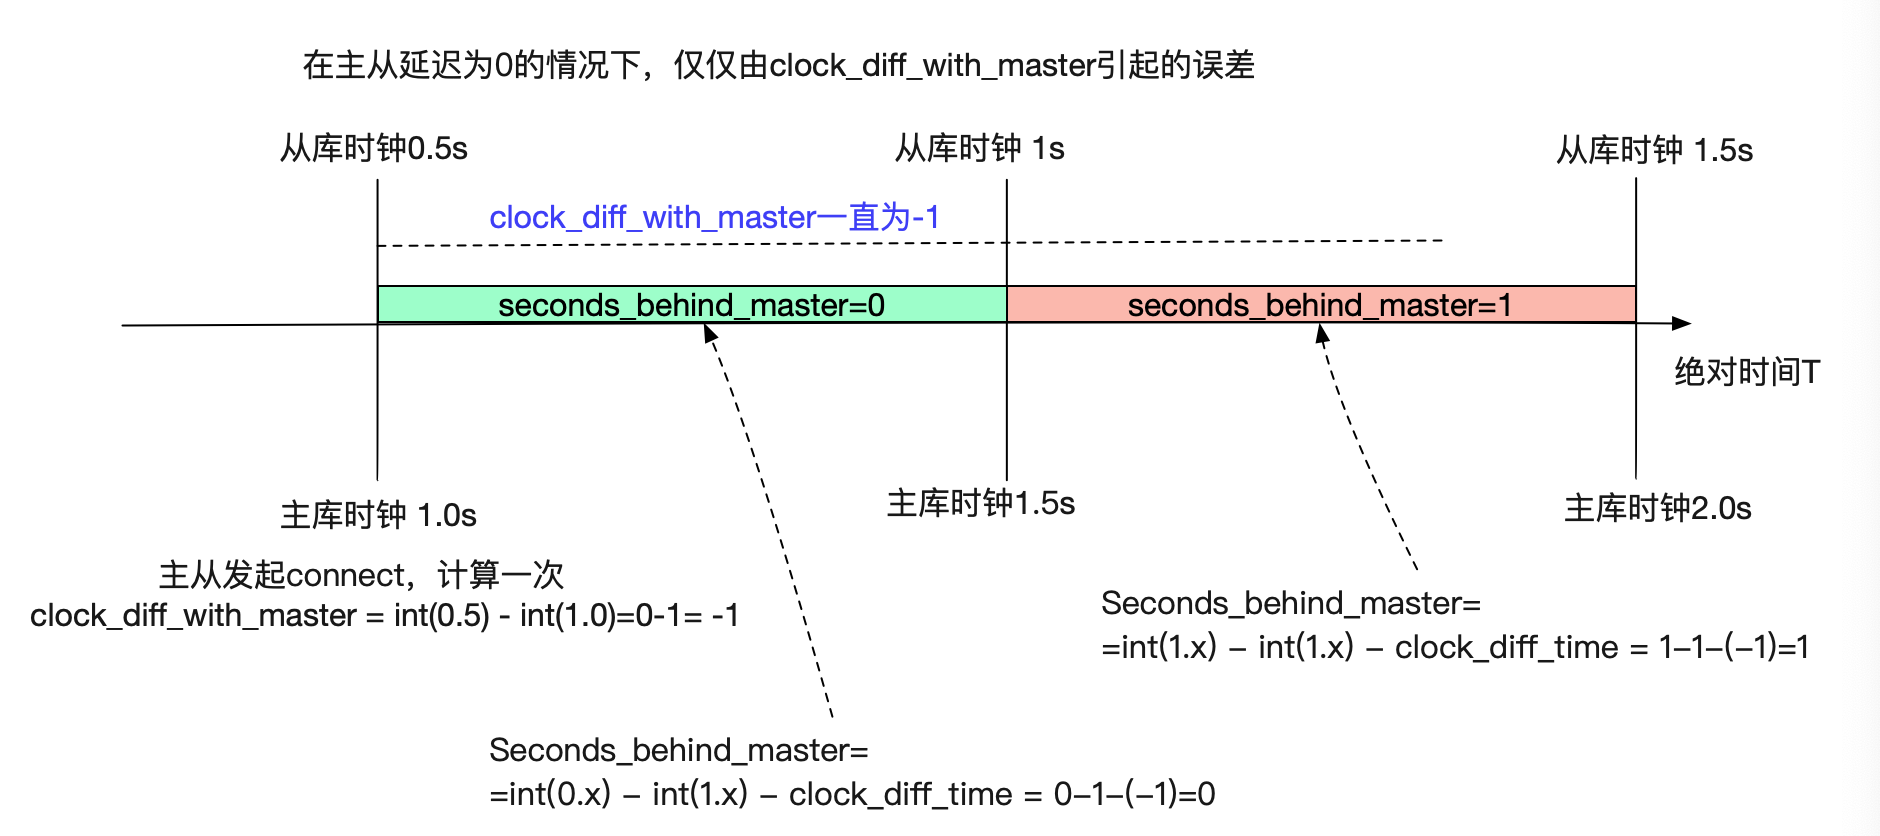
在主库时钟1.0s的时候从库发起connect,seconds_behind_master就很低为0。在主库时钟1.5s的时候从库发起connect,seconds_behind_master就为1。两个主从延迟都为0的从库,仅仅由于和主库建立连接时间点不一样就造成了一个比另一个差的假象,这就是这个seconds_behind_master指标由于精度问题给我们带来的幻觉。 详情可以见笔者的博客: https://www.alchemystar.net/articles/mysql-seconds-behind-master-fceee9b1.html
数据产生来源单一导致幻觉
数据来源也很容易导致幻觉,尤其是在我们要衡量不同节点之间差距的时候,如果数据来源只有一个节点,也就是只采集一个节点的数据做运算,那么就天然的无法反应出在节点间无法通信时候的状况,以至于让我们能产生这两节点没有任何差距的幻觉。seconds_behind_master这个主从延迟就能产生这种幻觉。
Seconds_behind_master = max(0,从库当前时间-正在回放时间的主库时间-主从时间差)
1.从库当前时间从 从库 取得
2.正在回放时间的主库时间是 当前从库正在回放的主库事件的时间戳,这个事件已经被从库接受了
3.主从时间差从 主从connect的那一刻取得
从上面的公式我们可以看出,在计算seconds_behind_master的这一刻并没有同时从主库获取任何信息。主库事件的时间戳也是从库中本身的已经接收到的信息。那很明显的,要衡量主从的差距没有主库事实信息的参与那肯定是不准确的。这个指标事实上只反应了SQL线程apply事件的时间和IO线程拉取到的事件时间的差距。 就举一个极端的例子,这时候主从网络断了,从库无法拉取到最新的主库时间,那么尽管主从延迟拉长到几十分钟,seconds_behind_master依旧为0,只有在主从重新建连的那一刻,才会有seconds_behind_master延迟了数十分钟的反应。这种情况在组织演练的时候就经常遇到,在模拟断网时刻一切静悄悄,一旦恢复类似的告警就会如潮水般涌来。如下图所示:
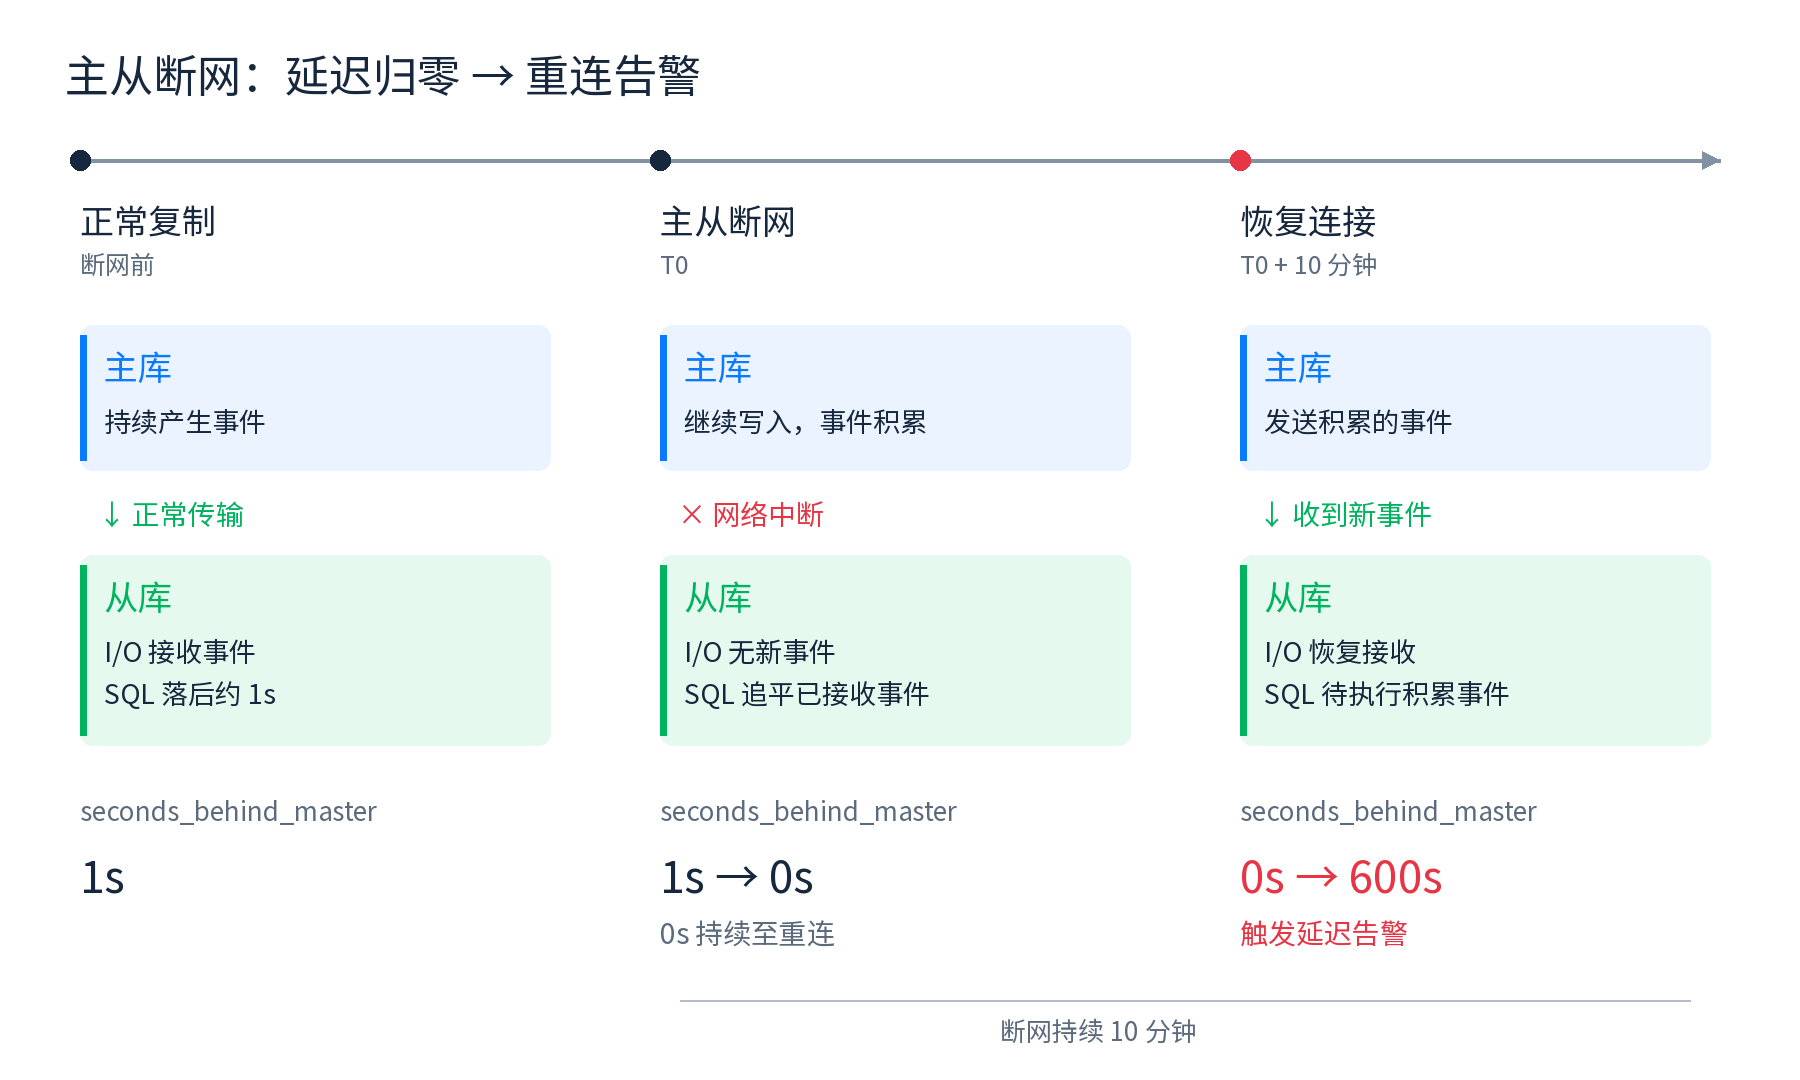
在这个例子里,我们就会在故障时刻产生啥问题都没有发生的岁月静好的幻觉,但实际已经造成了很长时间的影响。
数据被观测影响导致幻觉
观测本身也会影响数据的生产,有一些指标如果你做了某些特定的观测和不做这种观测会表现出不同的结果。笔者举一个例子Innodb_rows_inserted这个指标,其本身设计的指标是来观察数据库的插入负载, 但我们在做数据库的监控观测的时候,会频繁的运行下面这个命令:
select * from information_schema.processlist用来观察当前MySQL上的每个连接正在做什么,用来获取慢SQL/锁等待等信息。information_schema是一张MySQL内存里面的内部表,当我们在查询这张表的时候,其实会动态生成这张表。相应的,这张内部表生成时候的插入到这张表的记录也会增加到innodb_rows_inserted里面,尽管这个select命令!代码Stack如下:
fill_schema_processlist()
    ->schema_table_store_record()
        |->srv_stats_.n_rows_inserted.inc()
当我们连接数过多的时候,例如数千个,一次processlist命令就会增加数千条innodb_rows_inserted。假设10s探测一次,连接有5000个,那我们就会发现在分钟级的监控中由innodb_rows_inserted计算出的QPS平均多出了500TPS,如果我们有秒级监控则会发现在运行sql的那一秒突刺增加了5000。更有甚者,一旦发现数据库有问题,我们要动态加大观测频率的时候,这个效应就会急剧放大我们观测到的insert rows QPS,例如搞成1s一次,在分钟级的监控中QPS就会凭空增长5000!如下图所示:
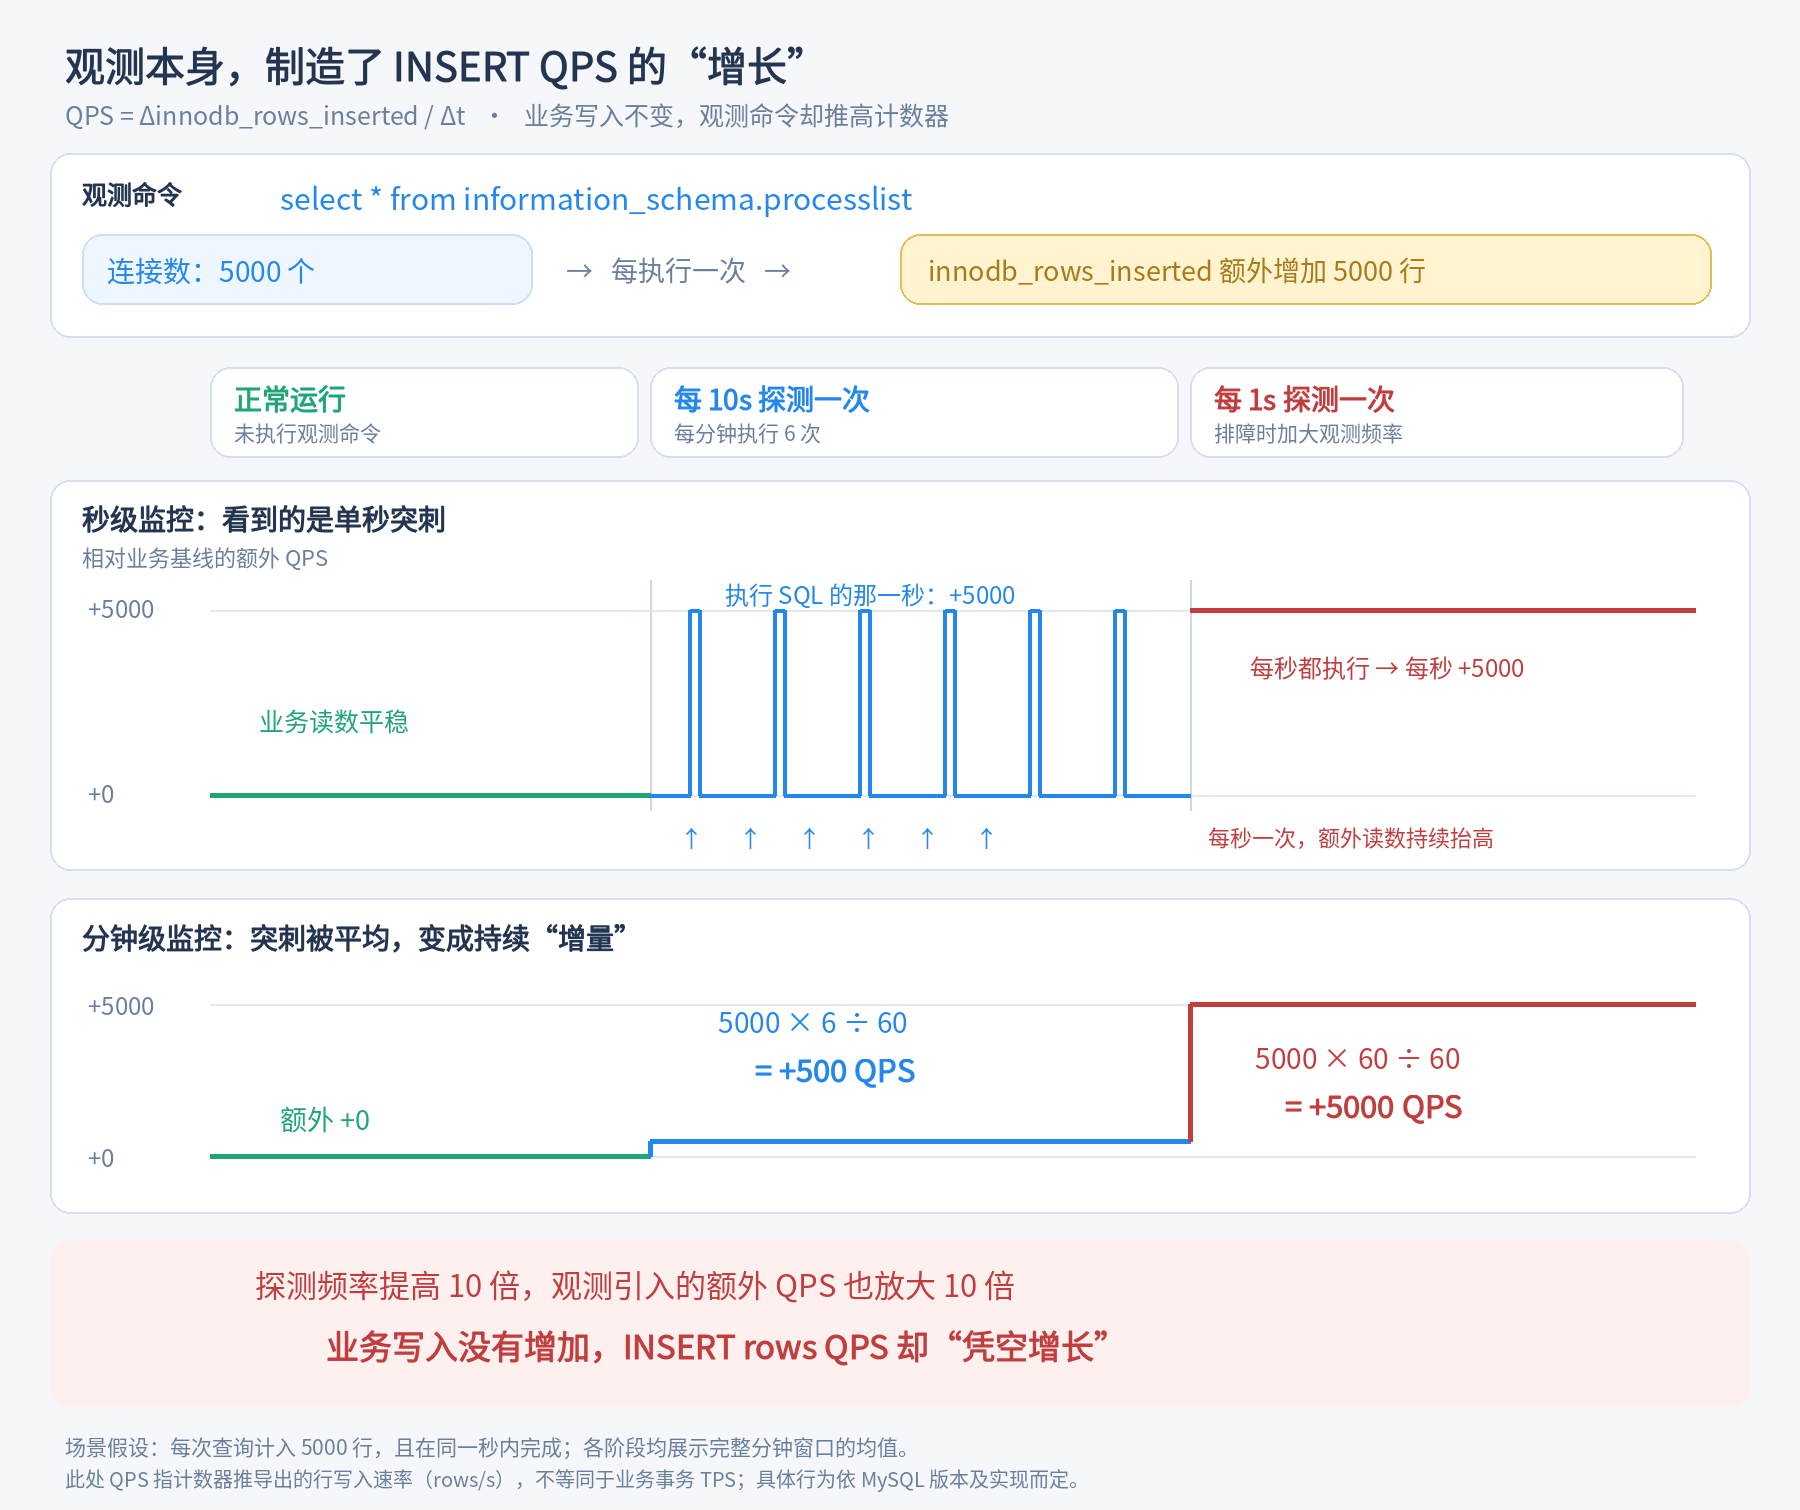
一旦没有意识到这个问题,这个监控指标就会直接将我们导入到MySQL负载暴增的错误方向!
数据语义漂移导致幻觉
指标的计算方式没有变化,但我们在解读它时,会不知不觉地切换概念。例如: Linux kernel的一个指标叫做throttled_time,linux源文档描述的是:
throttled_time: The total time duration (in nanoseconds) for which entities of the group have been throttled也就是该cgroup调度实体被限流的总时长。这个解读起来就有不少幻觉的空间,解读起来的语义会有各种漂移。 首先第一重幻觉:总时长是时间片而不是墙钟,我throttled_time 3.9s不代表我整个cgroup停顿了3.9s,而是不同的调度实体停顿增加起来的时间片是3.9s 第二重幻觉:调度实体并不是cgroup配置的CPU核数,只要没有绑核,调度实体可能分散在整个物理机上。 第三重幻觉:虽然cgroup运行的时间片和调度实体被限流的时间片计算方式都是在一个调度实体上用当前的时钟做delta。但运行时间片其实由于受cgroup的限制(例如配置了8C也就是800ms的时间片)最多只能到800ms,但受限制的时间片确由于没有这个限制所以可以累积到6400ms(分散在64核上)。如下图所示:
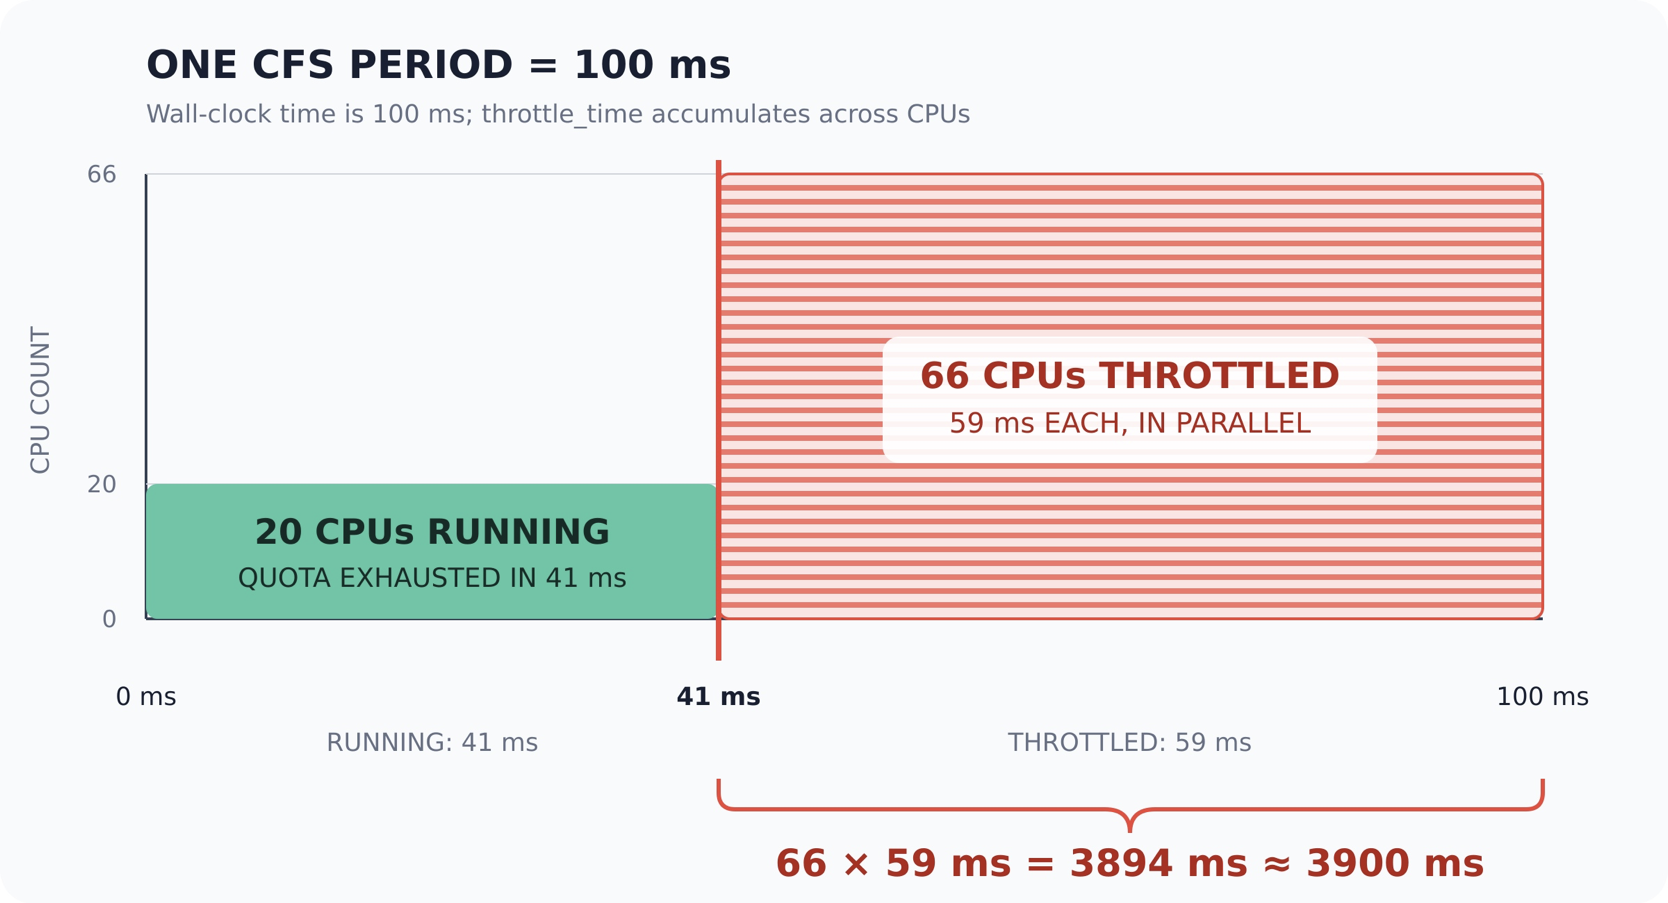
在这里,所以实际可运行的时间片和由于被限流导致停顿的时间片这两个都叫时间片其实表达的是不同的东西,一个是service_time,一个是wait_time。这个就像什么呢?两辆车发生剐蹭,处理花了这两辆车车主的10分钟(service_time=10*2=20分钟),但是确让后面一百辆车都等了10分钟也就是浪费了大家100*10=1000分钟时间一样。
在这个例子里面,同样一个“时间”,先被理解为墙钟时长,再被理解为跨调度实体累加的时长,最后又把运行时(service_time)与等待时间(wait_time)。当成了同一种时间。这种解读过程中含义的逐步滑动,就是语义的漂移。
具体问题可以见笔者的博客:
https://www.alchemystar.net/articles/bug-with-ai-909a31ae.html
值得注意的是,由于throttle_time在我们的监控体系里面是分钟级指标,笔者无法靠其发生的时间点来判定出CPU限流是导致线上系统问题的因还是果。于是通过日志造了一台示波器来解决了指标缺乏的问题。
读取时间点产生的幻觉
数据本身准确了,但是采集的时间点不一样,也会导致对于数据的解读不一样,进而造成幻觉。
读取时间点的相位固定导致幻觉
监控往往是从用定时的方式从对应的机器取相关的机器,例如每分钟一次。那么如果每分钟内负载其实有相当大的波动,在前30s之内,CPU能到50%,在后30s,CPU只能到10%,但监控取点在这一分钟的相位往往是固定的,例如A机器固定在第10s取点,B机器固定在第50s取点,在监控看来A机器的CPU负载就是B机器的五倍。如下图所示:
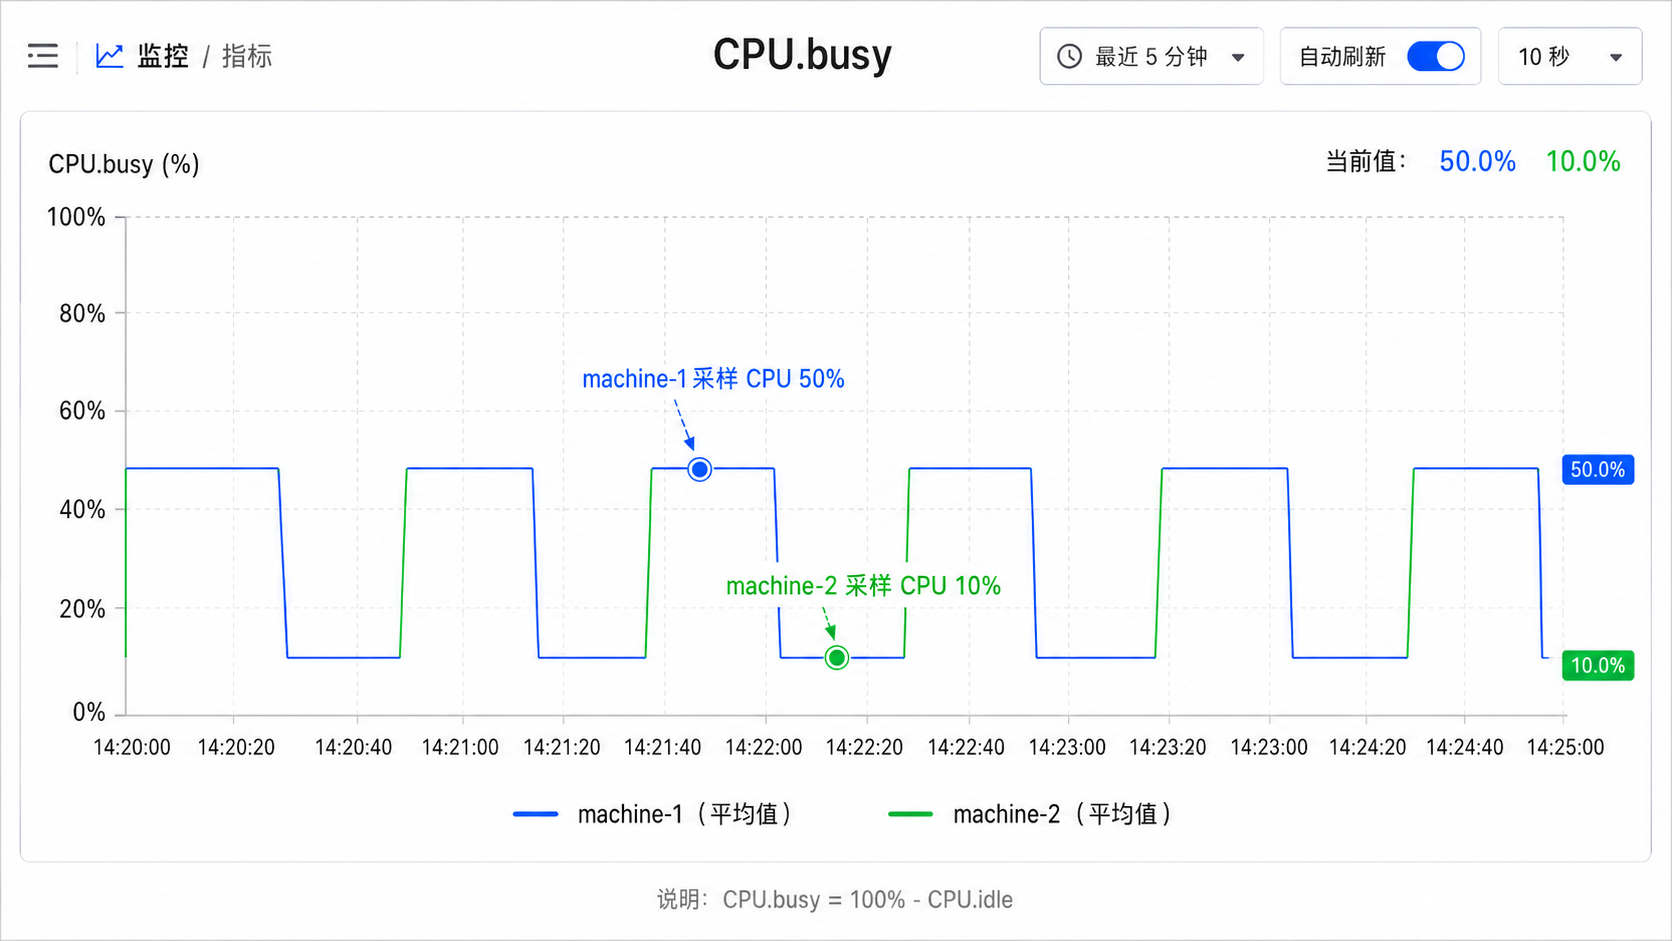
如果我们无法识别出来这是由监控带来的相位幻觉,那其实非常容易将我们排查问题的走向转向机器负载不均衡。 具体问题可以见笔者的博客: https://www.alchemystar.net/articles/cpu-busy-5-7a232df0.html
读取时间点的相位漂移导致幻觉
相位漂移会产生更加隐蔽的幻觉,而且会在很大程度上影响我们的排查方向。固定的相位漂移会将我们误导到这是一个长周期的问题。就举一个很经典的例子,这也是笔者和另一位同学一块排查的。这是一个CPU load每隔7小时就会飙高并持续8分钟的问题。很明显的,按照通用的思路,我们应该排查每7个小时一次的定时任务,但我们始终无法找到。那后续我们采用的方案是采用ebpf抓那8分钟的CPU load对应的nr_running计数,比对过数据发现每分钟都会在第37s的时间点有将近100ms的nr_running高。但这个100ms的nr_running高在故障时间段之外依旧保持同样的第35s高,没有任何变化。这就让我们不得不怀疑起采样点的相位漂移问题。看了下源代码,CPU load的采样周期是:
CPU load : 5HZ + 1tick 对应于现代服务器CONFIG_HZ=1000也就是5s+1ms也就是下一次采样的时候会产生1ms的漂移。这就造成了这个非常诡异的7小时”周期性”问题想象。 在这里笔者先给出一个图例吧:
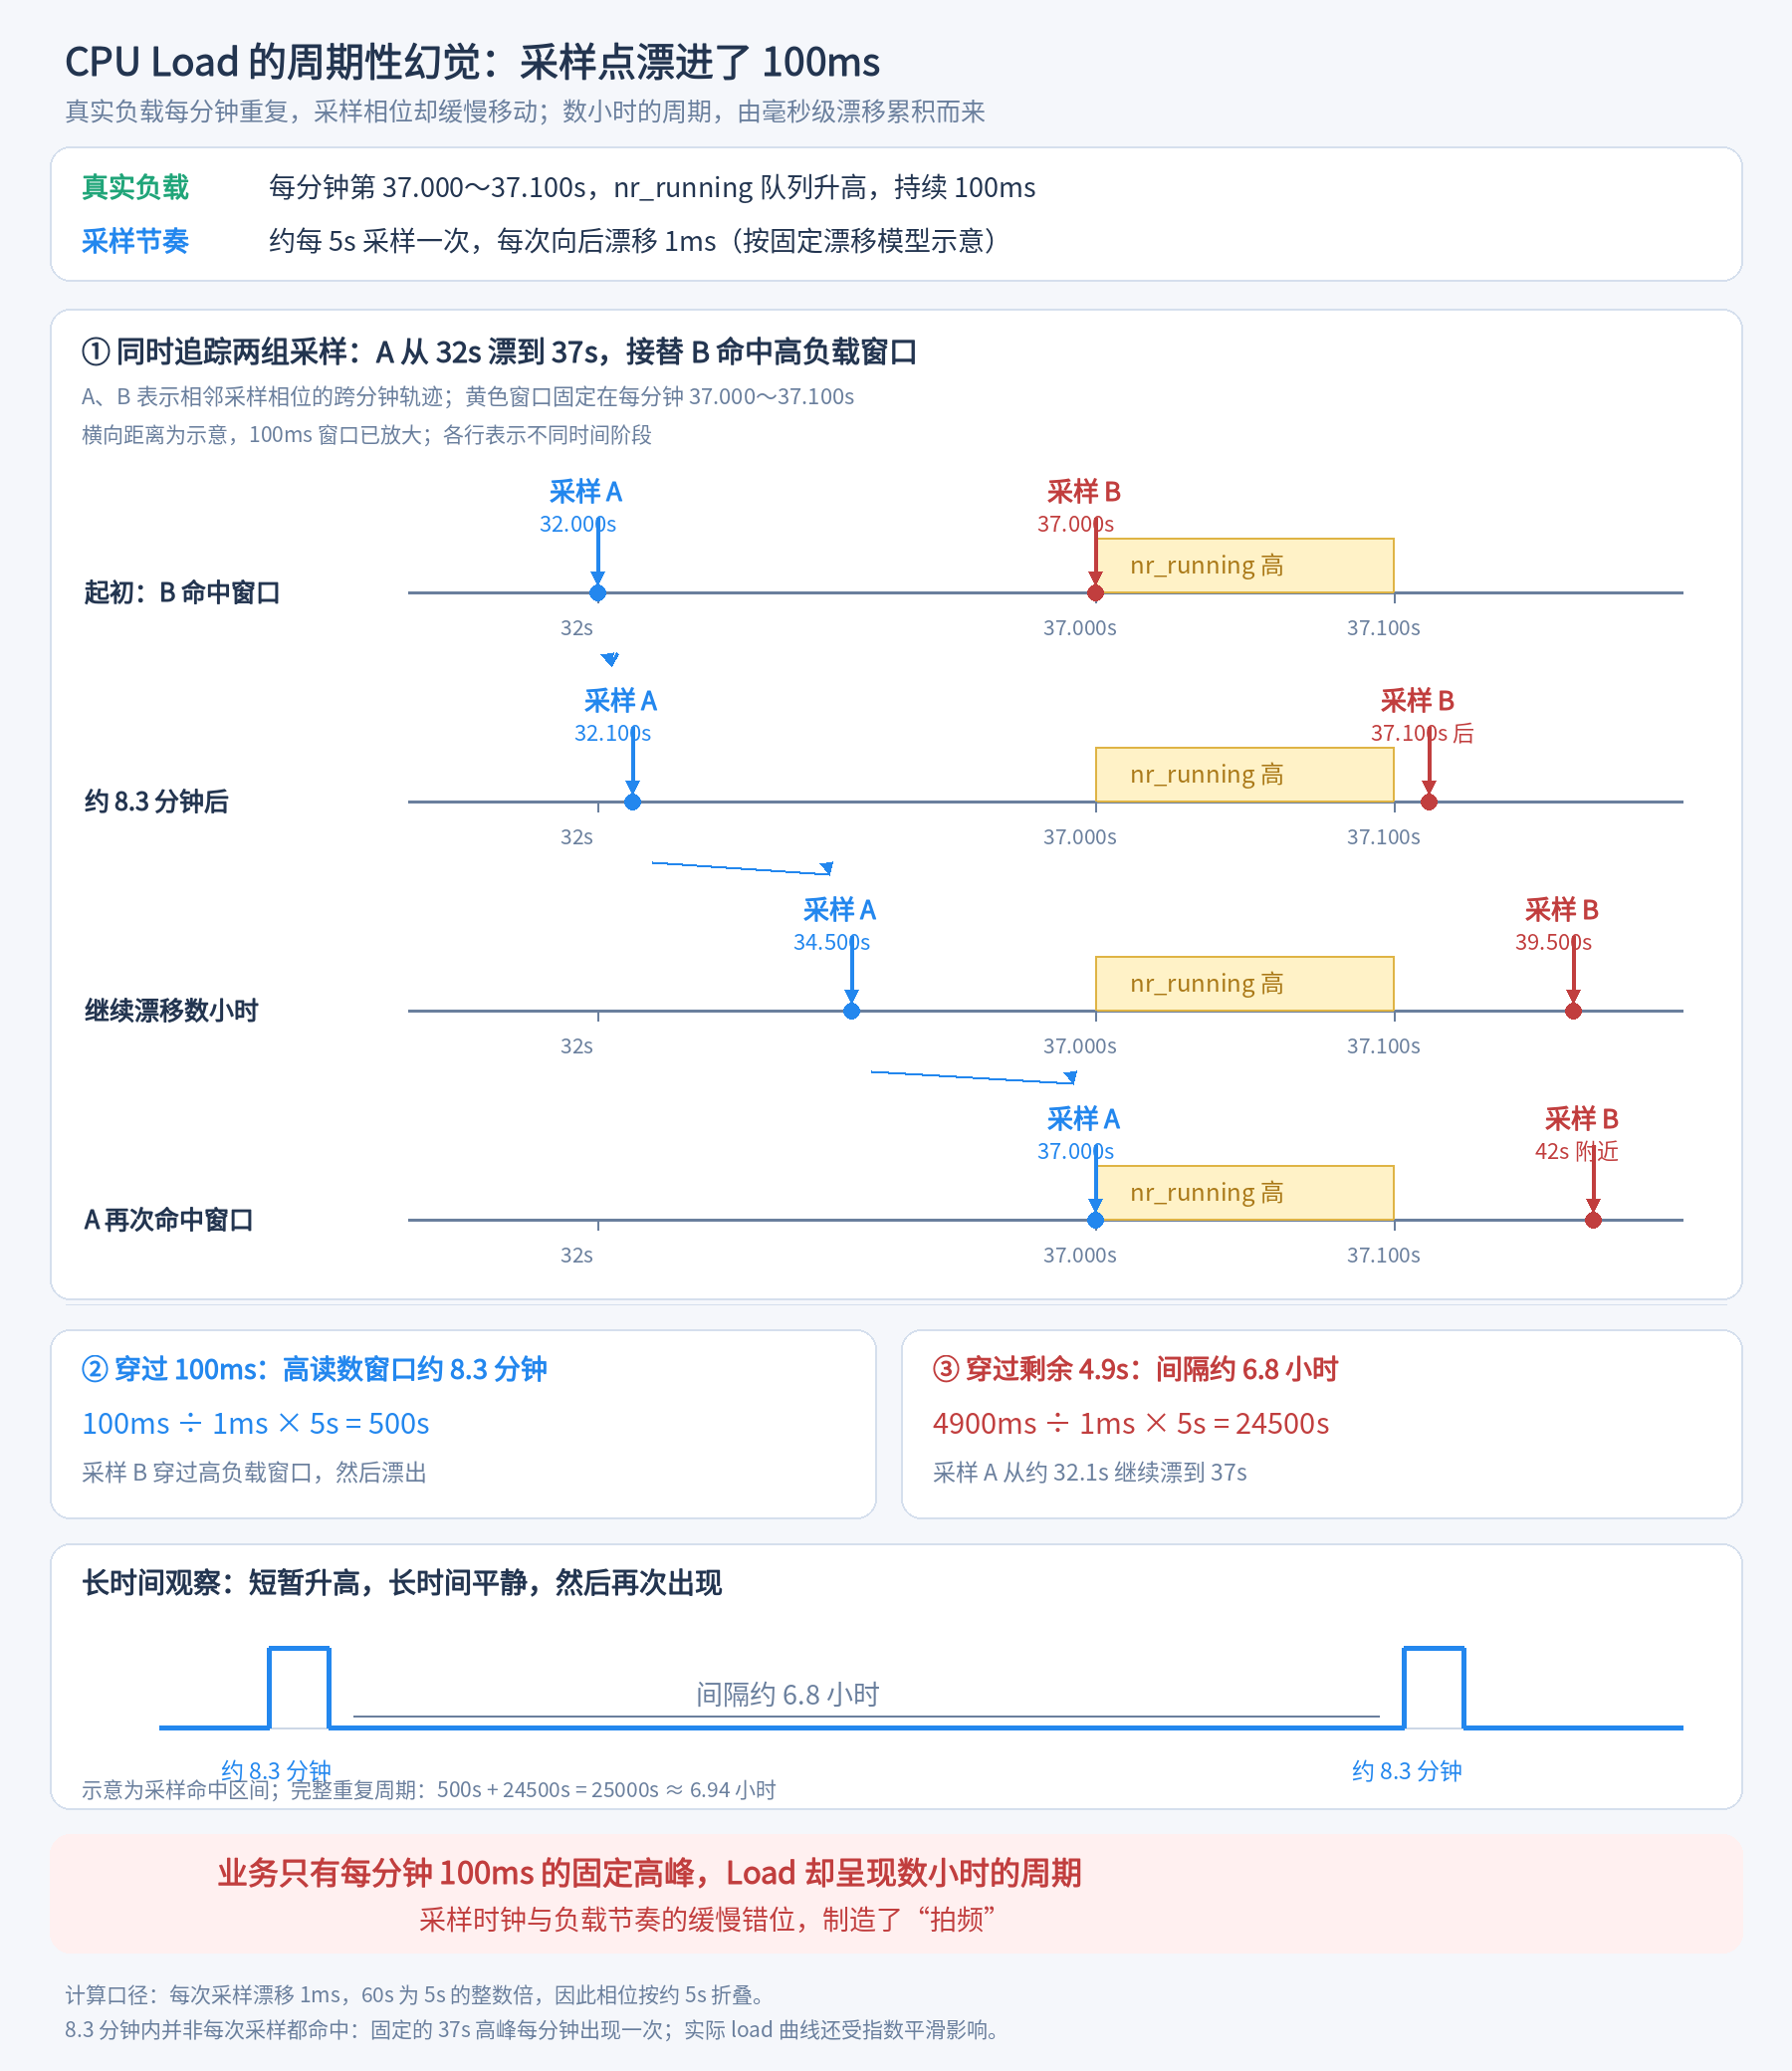
首先解释为什么会cpu load高8分钟: 很明显的,100ms需要100次采样才能漂移走,对应于1次5s也就是100*5=500s也就是8.3分钟。 第二解释为什么每隔大约7小时会cpu load变高: 很明显的,只要cpu load采集相位漂进这一分钟的100ms,就会飙高。那么在原来第37s的CPU load漂走之后。下一个能漂进来的是原来第32s的采样,它需要漂5s-100ms也就是4900ms才能到打第37s这个相位,那么每漂1ms需要5s时间,那么漂4900次就是(4900*5)为24500s,也就是6.8小时。在我们进一步确认了详细的周期时间间隔后完美的对应上了,一分钟都不差。
不同时间抓取的关联数据没有原子性导致的幻觉
当我们在采集一个指标的时,如果要要抓两份相关联的数据,例如A和B,这两份数据往往没有事务的保证。那么在系统的瞬态快照里面A和B是一致的,但是分了两次抓取后,B数据已经改变了,当我们对A和B做相关运算的时候就会得到错误的结果。那其实在上面的相位漂移的例子排查过程中也遇到了这种幻觉。这也是我们为什么会采用ebpf去观察nr_running的原因。因为通常的PS命令无法抓到短进程,我们以100ms的精度去抓,发现进程数量少的可怜,但是用ebpf中的工具确能抓到大量短进程。答案就在PS需要抓取多次数据,而这多次数据间的不一致导致他无法正常的展示出短进程。整个过程如下图所示:
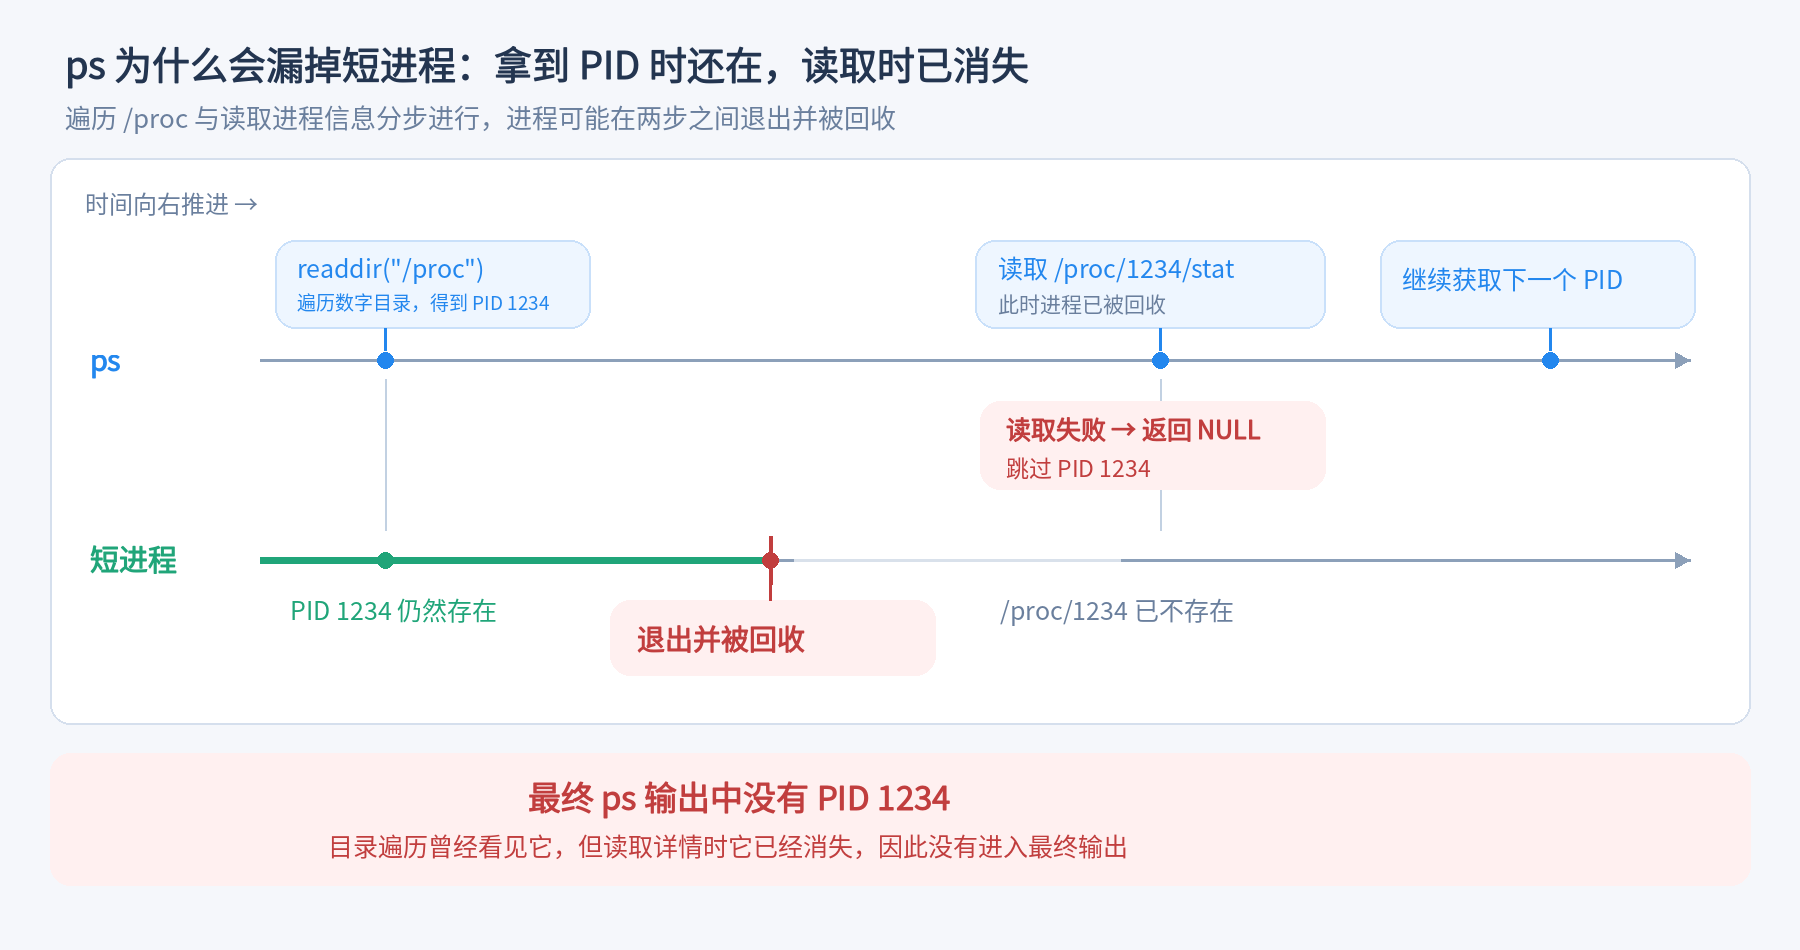
由于/proc下的PID和stat数据之间没有做一致性的保护。就会导致系统里虽然存在的大量短进程,但是我们依旧产生了进程数很少的幻觉。
值得注意的是,导致这个37s的突刺实际上是个监控系统在100ms之内新建了大量短进程取抓取其它机器的数据。这不得不说是观测系统自身导致了观测问题的又一个例子。
窗口选择导致幻觉
.......未完待续
框架
框架
指标都是事实的投影,我们无法去拿到确切的真实。我们为了解决观测失真的问题,会在各种层面进行侧重,但每侧重一个方面往往会引起另一个方面的削弱。例如为了解决相位固定问题引入了相位漂移确会造成更加隐蔽的假周期性问题,为了提高观测频率确引入了虚假的QPS,为了获取更多的观测数据又引入了数据间的一致性问题。那么指标到底在什么边界可信就是需要我们判断的问题,我们必须仔细的Review指标的计算方式以及基础假设,在指标出现了和事实明显偏差的时候,我们需要能够怀疑指标并寻找其它指标,亦或者自己造新的指标才能解决相应问题。
指标只是事实的投影。为了弥补一种观测缺陷,我们会改变采样时刻、提高探测频率,或组合更多数据;这些改动可能消除原有误差,也可能引入新的偏差。因此,指标是否可信,必须结合具体判断来回答:它实际记录了什么,我们希望据此推断什么,两者之间依赖哪些条件?当指标与独立证据矛盾时,应检查这些条件,并通过其他观测方式验证。